Modelo, temperatura e limite de tokens
Nos ajustes do agente você escolhe o modelo de cada provedor e regula a temperatura, o limite de tokens, o raciocínio e o tamanho das respostas.
O modelo é a IA que escreve as respostas do agente. Cada provedor tem vários, com preços e velocidades diferentes. Os outros ajustes regulam o jeito de responder: mais previsível ou mais variado, mais curto ou mais longo, com mais ou menos raciocínio.
Tudo fica no ícone de ajustes, à direita de Mensagem do sistema, no editor do agente.
Como funciona
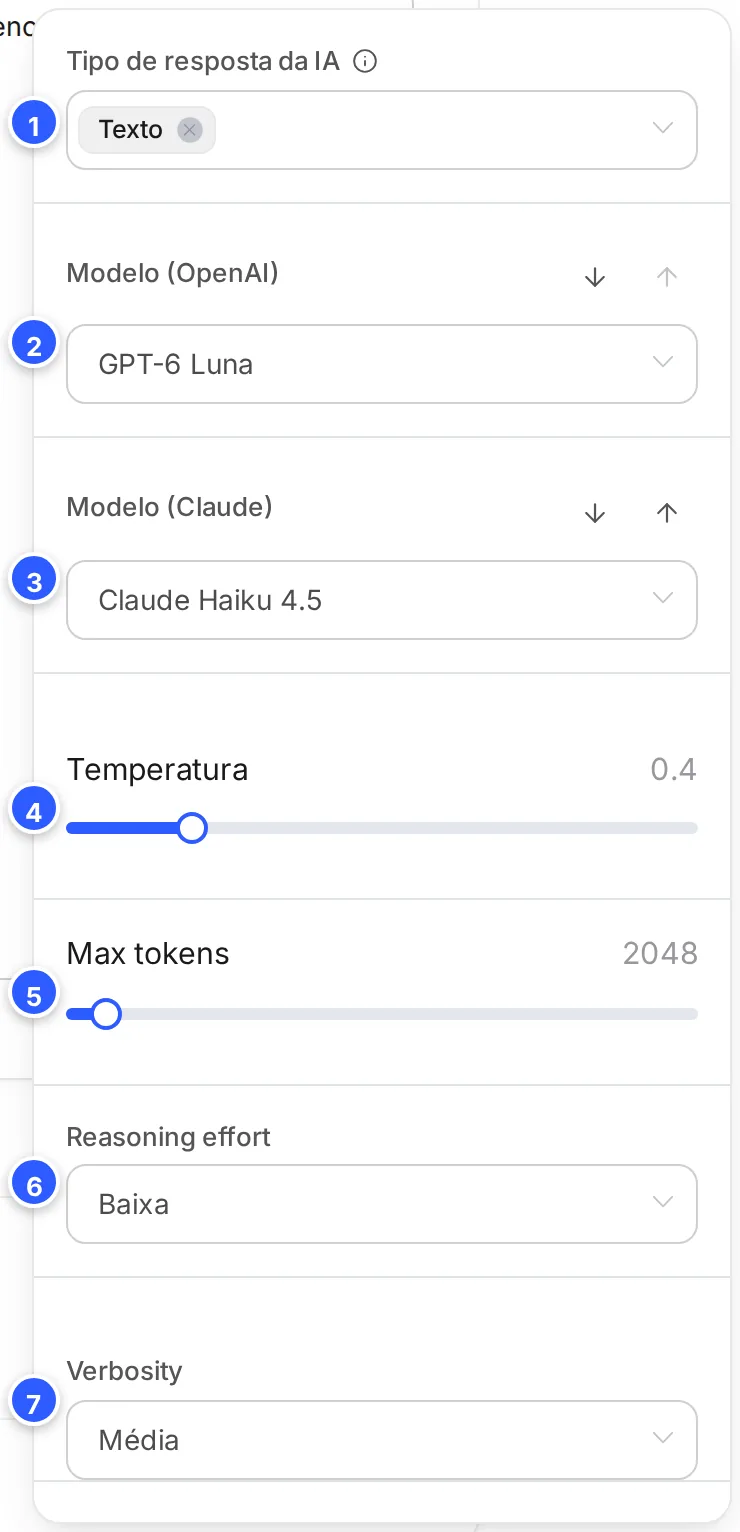
- Tipo de resposta da IA: só texto ou também mídia, botões e carrossel. Veja Tipos de resposta.
- Modelo (OpenAI): o modelo da OpenAI.
- Modelo (Claude): o modelo do Claude. Cada provedor conectado tem o seu Modelo.
- Temperatura: de 0 a 2. Vem com 0,4.
- Max tokens: de 1 a 32768. Vem com 2048.
- Reasoning effort: Nenhum, Baixa, Média ou Alta. Vem com Baixa.
- Verbosity: Baixa, Média ou Alta. Vem com Média.
Depois de mudar, clique em Salvar, no alto do editor.
Modelo
A lista de modelos vem do próprio provedor, com a sua chave. Por isso ela muda quando o provedor lança ou aposenta um modelo. O agente novo já vem com um modelo escolhido para cada provedor.
Com mais de um provedor conectado, aparece um Modelo para cada um, e as setas ao lado do nome mudam a ordem deles na lista.
Se o modelo salvo no agente sair da lista do provedor, o editor mostra o primeiro modelo da lista no lugar. A troca só vale depois de Salvar.
Para comparar os modelos, veja a página de cada provedor: OpenAI, Google Gemini, Claude, xAI e DeepSeek.
Temperatura
Regula quanto as respostas variam. Mais baixa, respostas mais previsíveis; mais alta, mais variadas. Para atendimento, em que o agente precisa seguir as regras da empresa, fique em valores baixos, como o 0,4 que vem marcado. A tela mostra o número com ponto: 0.4.
Max tokens
É o tamanho máximo de cada resposta, contado em tokens (pedaços de palavras). Quando chega ao limite, o provedor para de escrever, e a resposta pode sair cortada. Um limite mais baixo também segura o custo de cada resposta.
Reasoning effort e Verbosity
Aparecem só com os modelos que aceitam esses ajustes, como os mais novos da OpenAI. O Reasoning effort também aparece com alguns modelos do xAI e do DeepSeek.
- Reasoning effort: quanto o modelo pensa antes de responder. Mais raciocínio deixa a resposta mais demorada e pode aumentar o custo. Para perguntas simples, Nenhum ou Baixa bastam.
- Verbosity: o tamanho da resposta final. Uma instrução clara na mensagem do sistema, como "responda em até 3 frases", vale mais do que esse ajuste.
No fluxo, os nomes mudam um pouco
A ação Gerar texto dos fluxos tem a mesma Temperatura, de 0 a 2, que vem com 0,4. O limite se chama Maximum number of output tokens, vai até 32000 e vem com 8000. Veja Chamar a IA no fluxo.
Quando usar
- Respostas longas demais: escreva o tamanho na mensagem do sistema e, se precisar, baixe o Max tokens ou a Verbosity.
- Respostas cortadas no meio: aumente o Max tokens.
- Respostas criativas demais ou fora das regras: baixe a Temperatura.
- Respostas fracas em perguntas difíceis: experimente um modelo maior ou um Reasoning effort mais alto.
- Respostas lentas ou caras: experimente um modelo menor e um Reasoning effort mais baixo. Veja Quanto custa usar a IA.
Boas práticas
Mude uma coisa de cada vez
Troque um ajuste, salve e teste. Assim você sabe o que fez diferença. Veja Testar e ajustar o agente.
Comece pelo texto
Antes de mexer nos ajustes, confira se a mensagem do sistema diz claramente o que você quer. Veja Escrever a mensagem do sistema.
Na dúvida, mantenha o que vem marcado
Os valores que vêm marcados são um bom começo: mude só o que o teste mostrar. Veja também Qual modelo de IA devo usar?.
Relacionados
Este conteúdo ajudou?
Obrigado! Sua resposta ajuda a melhorar a central.